从零到一手写操作系统(七、内存 5)linux buddy system)
如果追忆会荡起涟漪,那么今天的秋红落叶和晴空万里都归你
https://aeneag.xyz
微信公众号:技术乱舞
艾恩凝
手写操作系统目录
7.7)buddy system(Linux)
linux系统中,管理物理内存页面的是伙伴系统,负责分配比页更小的内存对象是slab分配器
7.7.1)表示页page
Linux 也是使用分页机制管理物理内存的,即 Linux 把物理内存分成 4KB 大小的页面进行管理。目前宏观了解linux内核中,一个 page 结构表示一个物理内存页面。
7.7.2)表示区zone
linux内核中,因为有硬件限制,所有物理内存页并不能归结为同样的属性。因此把相同属性的物理内存页面归结到了一个区中。
区的划分根据不同的硬件平台划分。
enum migratetype {
    MIGRATE_UNMOVABLE, //不能移动的
    MIGRATE_MOVABLE,   //可移动和
    MIGRATE_RECLAIMABLE,
    MIGRATE_PCPTYPES,  //属于pcp list的
    MIGRATE_HIGHATOMIC = MIGRATE_PCPTYPES,
#ifdef CONFIG_CMA
    MIGRATE_CMA,   //属于CMA区的
#endif
#ifdef CONFIG_MEMORY_ISOLATION
    MIGRATE_ISOLATE,
#endif
    MIGRATE_TYPES
};
//页面空闲链表头
struct free_area {
    struct list_head    free_list[MIGRATE_TYPES];
    unsigned long       nr_free;
};
struct zone {
    unsigned long _watermark[NR_WMARK];
    unsigned long watermark_boost;
    //预留的内存页面数
    unsigned long nr_reserved_highatomic;
    //内存区属于哪个内存节点
#ifdef CONFIG_NUMA
    int node;
#endif
    struct pglist_data  *zone_pgdat;
    //内存区开始的page结构数组的开始下标
    unsigned long       zone_start_pfn;
    atomic_long_t       managed_pages;
    //内存区总的页面数
    unsigned long       spanned_pages;
    //内存区存在的页面数
    unsigned long       present_pages;
    //内存区名字
    const char      *name;
    //挂载页面page结构的链表
    struct free_area    free_area[MAX_ORDER];
    //内存区的标志
    unsigned long       flags;
    /*保护free_area的自旋锁*/
    spinlock_t      lock;
};
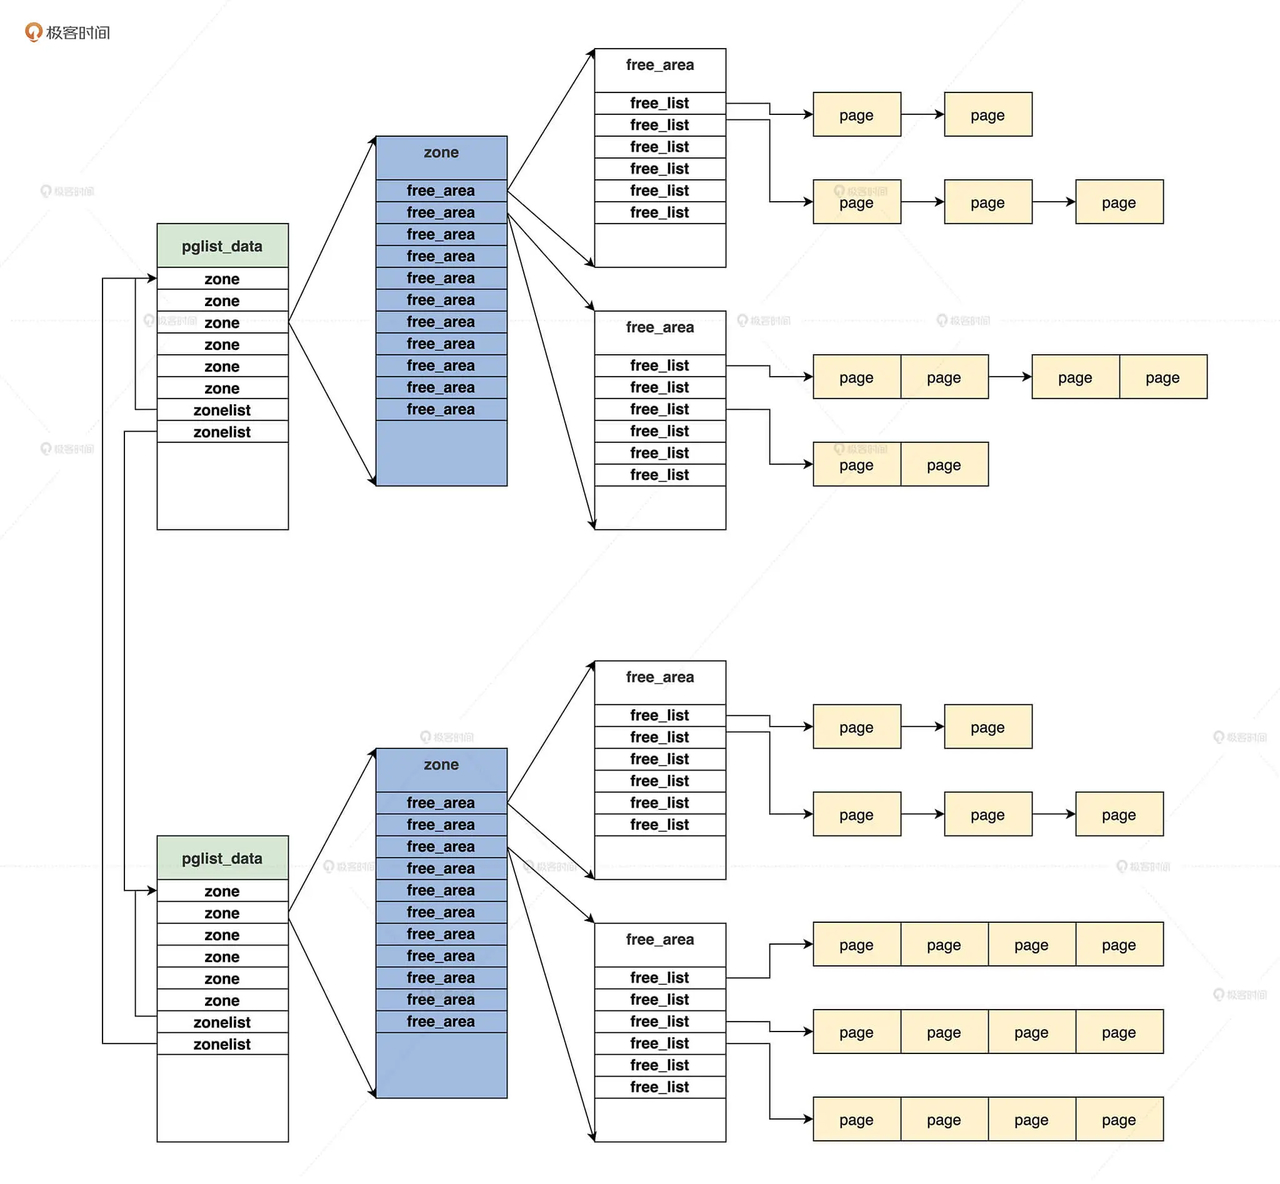
free_area结构数组,就是实现伙伴系统的重要结构,MAX_ORDER 的值默认为 11,分别表示挂载地址连续的 page 结构数目为 1,2,4,8,16,32……最大为 1024。
free_area 结构中又是一个 list_head 链表数组,该数组将具有相同迁移类型的 page 结构尽可能地分组,有的页面可以迁移,有的不可以迁移,同一类型的所有相同 order 的 page 结构,就构成了一组 page 结构块。
这样做的目的就是为了让内存页迁移更加高效,可以有效降低内存碎片。
7.7.3)表示内存节点
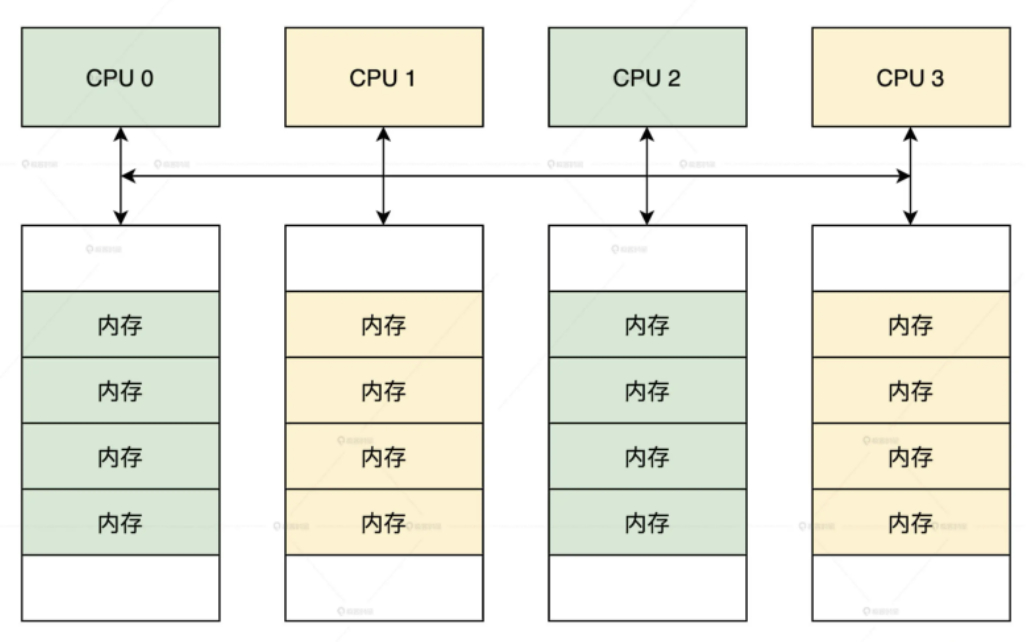
在很多服务器和大型计算机上,如果物理内存是分布式的,由多个计算节点组成,那么每个 CPU 核都会有自己的本地内存,CPU 在访问它的本地内存的时候就比较快,访问其他 CPU 核内存的时候就比较慢,这种体系结构被称为 Non-Uniform Memory Access(NUMA)。
struct zoneref {
    struct zone *zone;//内存区指针
    int zone_idx;     //内存区对应的索引
};
struct zonelist {
    struct zoneref _zonerefs[MAX_ZONES_PER_ZONELIST + 1];
};
//zone枚举类型 从0开始
enum zone_type {
#ifdef CONFIG_ZONE_DMA
    ZONE_DMA,
#endif
#ifdef CONFIG_ZONE_DMA32
    ZONE_DMA32,
#endif
    ZONE_NORMAL,
#ifdef CONFIG_HIGHMEM
    ZONE_HIGHMEM,
#endif
    ZONE_MOVABLE,
#ifdef CONFIG_ZONE_DEVICE
    ZONE_DEVICE,
#endif
    __MAX_NR_ZONES

};
//定义MAX_NR_ZONES为__MAX_NR_ZONES 最大为6
DEFINE(MAX_NR_ZONES, __MAX_NR_ZONES);
//内存节点
typedef struct pglist_data {
    //定一个内存区数组,最大为6个zone元素
    struct zone node_zones[MAX_NR_ZONES];
    //两个zonelist,一个是指向本节点的的内存区,另一个指向由本节点分配不到内存时可选的备用内存区。
    struct zonelist node_zonelists[MAX_ZONELISTS];
    //本节点有多少个内存区
    int nr_zones;
    //本节点开始的page索引号
    unsigned long node_start_pfn;
    //本节点有多少个可用的页面
    unsigned long node_present_pages;
    //本节点有多少个可用的页面包含内存空洞
    unsigned long node_spanned_pages;
    //节点id
    int node_id;
    //交换内存页面相关的字段
    wait_queue_head_t kswapd_wait;
    wait_queue_head_t pfmemalloc_wait;
    struct task_struct *kswapd;
    //本节点保留的内存页面
    unsigned long       totalreserve_pages;
    //自旋锁
    spinlock_t      lru_lock;
} pg_data_t;
自己实现的系统类似于伙伴系统。
7.7.4)伙伴结构
7.7.5)分配页面
首先要找到内存节点,接着找到内存区,然后合适的空闲链表,最后在其中找到页的 page 结构,完成物理内存页面的分配。
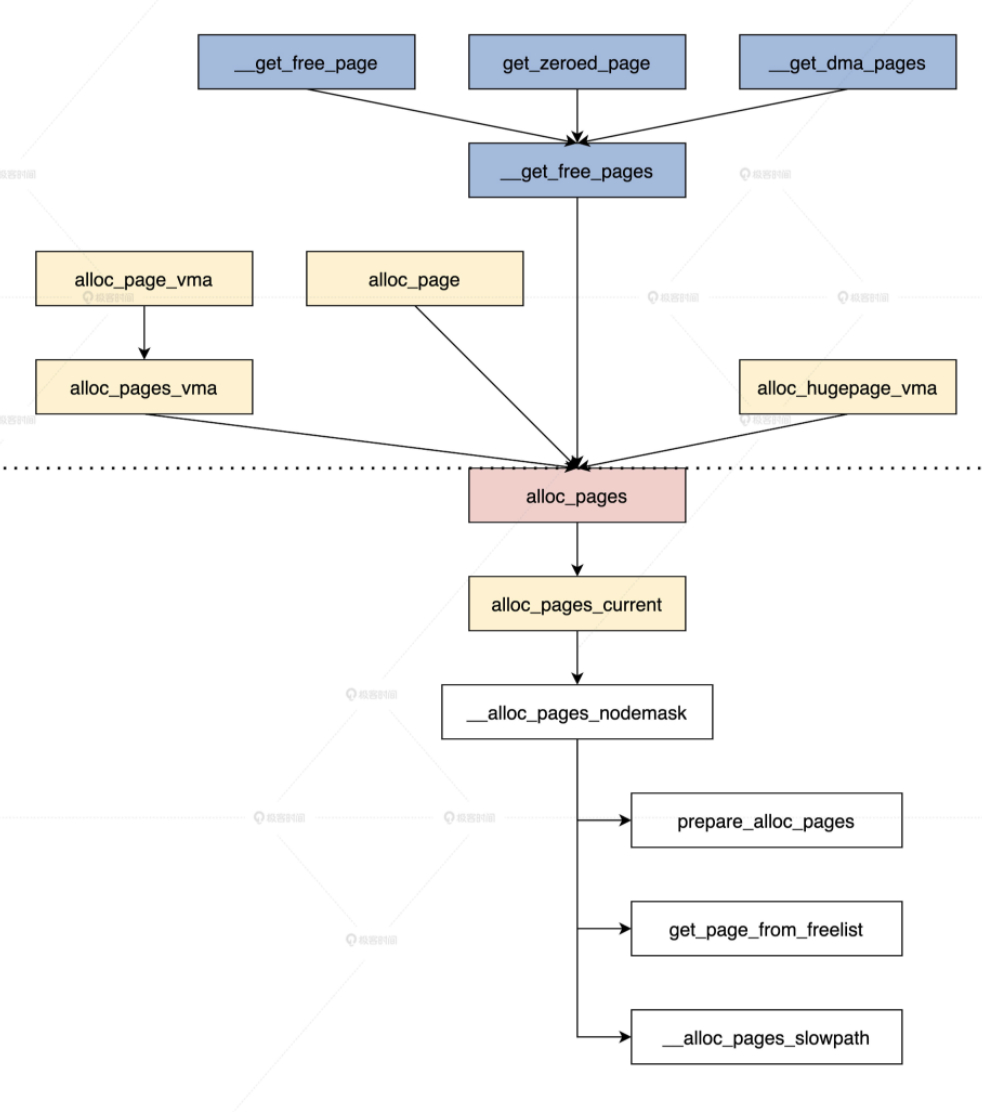
所有的接口函数都会调用到 alloc_pages 函数,而这个函数最终会调用 __alloc_pages_nodemask 函数完成内存页面的分配。
分配:
内存页面的主要函数,这个 __alloc_pages_nodemask 函数主要干了三件事
- 准备分配页面的参数;
- 进入快速分配路径;
- 若快速分配路径没有分配到页面,就进入慢速分配路径。
struct page *__alloc_pages_nodemask(gfp_t gfp_mask, unsigned int order, int preferred_nid,  nodemask_t *nodemask)
{
    struct page *page;
    unsigned int alloc_flags = ALLOC_WMARK_LOW;
    gfp_t alloc_mask;
    struct alloc_context ac = { };
    //分配页面的order大于等于最大的order直接返回NULL
    if (unlikely(order >= MAX_ORDER)) {
        WARN_ON_ONCE(!(gfp_mask & __GFP_NOWARN));
        return NULL;
    }
    gfp_mask &= gfp_allowed_mask;
    alloc_mask = gfp_mask;
    //准备分配页面的参数放在ac变量中
    if (!prepare_alloc_pages(gfp_mask, order, preferred_nid, nodemask, &ac, &alloc_mask, &alloc_flags))
        return NULL;
    alloc_flags |= alloc_flags_nofragment(ac.preferred_zoneref->zone, gfp_mask);
    //进入快速分配路径
    page = get_page_from_freelist(alloc_mask, order, alloc_flags, &ac);
    if (likely(page))
        goto out;
    alloc_mask = current_gfp_context(gfp_mask);
    ac.spread_dirty_pages = false;
    ac.nodemask = nodemask;
    //进入慢速分配路径
    page = __alloc_pages_slowpath(alloc_mask, order, &ac);
out:
    return page;
}
准备分配页面的参数
struct alloc_context {
    struct zonelist *zonelist;
    nodemask_t *nodemask;
    struct zoneref *preferred_zoneref;
    int migratetype;
    enum zone_type highest_zoneidx;
    bool spread_dirty_pages;
};

static inline bool prepare_alloc_pages(gfp_t gfp_mask, unsigned int order,
        int preferred_nid, nodemask_t *nodemask,
        struct alloc_context *ac, gfp_t *alloc_mask,
        unsigned int *alloc_flags)
{
    //从哪个内存区分配内存
    ac->highest_zoneidx = gfp_zone(gfp_mask);
    //根据节点id计算出zone的指针
    ac->zonelist = node_zonelist(preferred_nid, gfp_mask);
    ac->nodemask = nodemask;
    //计算出free_area中的migratetype值,比如如分配的掩码为GFP_KERNEL,那么其类型为MIGRATE_UNMOVABLE;
    ac->migratetype = gfp_migratetype(gfp_mask);
    //处理CMA相关的分配选项
    *alloc_flags = current_alloc_flags(gfp_mask, *alloc_flags);
    ac->spread_dirty_pages = (gfp_mask & __GFP_WRITE);
    //搜索nodemask表示的节点中可用的zone保存在preferred_zoneref
    ac->preferred_zoneref = first_zones_zonelist(ac->zonelist,
                    ac->highest_zoneidx, ac->nodemask);
    return true;
}
repare_alloc_pages 函数根据传递进入的参数,就能找出要分配内存区、候选内存区以及内存区中空闲链表的 migratetype 类型。它把这些全部收集到 ac 结构中,只要它返回 true,就说明分配内存页面的参数已经准备ok
快速分配路径
快速分配路径不会处理内存页面合并和回收
这个函数的逻辑就是遍历所有的候选内存区,然后针对每个内存区检查水位线,是不是执行内存回收机制,当一切检查通过之后,就开始调用 rmqueue 函数执行内存页面分配。
慢速分配路径
慢速路径最主要的不同是它会执行页面回收,回收页面之后会进行多次重复分配,直到最后分配到内存页面,或者分配失败
static inline struct page *
__alloc_pages_slowpath(gfp_t gfp_mask, unsigned int order,
                        struct alloc_context *ac)
{
    bool can_direct_reclaim = gfp_mask & __GFP_DIRECT_RECLAIM;
    const bool costly_order = order > PAGE_ALLOC_COSTLY_ORDER;
    struct page *page = NULL;
    unsigned int alloc_flags;
    unsigned long did_some_progress;
    enum compact_priority compact_priority;
    enum compact_result compact_result;
    int compaction_retries;
    int no_progress_loops;
    unsigned int cpuset_mems_cookie;
    int reserve_flags;

retry:
    //唤醒所有交换内存的线程
    if (alloc_flags & ALLOC_KSWAPD)
        wake_all_kswapds(order, gfp_mask, ac);
    //依然调用快速分配路径入口函数尝试分配内存页面
     page = get_page_from_freelist(gfp_mask, order, alloc_flags, ac);
    if (page)
        goto got_pg;

    //尝试直接回收内存并且再分配内存页面
    page = __alloc_pages_direct_reclaim(gfp_mask, order, alloc_flags, ac,
                            &did_some_progress);
    if (page)
        goto got_pg;

    //尝试直接压缩内存并且再分配内存页面
    page = __alloc_pages_direct_compact(gfp_mask, order, alloc_flags, ac,
                    compact_priority, &compact_result);
    if (page)
        goto got_pg;
    //检查对于给定的分配请求,重试回收是否有意义
    if (should_reclaim_retry(gfp_mask, order, ac, alloc_flags,
                 did_some_progress > 0, &no_progress_loops))
        goto retry;
    //检查对于给定的分配请求,重试压缩是否有意义
    if (did_some_progress > 0 &&
            should_compact_retry(ac, order, alloc_flags,
                compact_result, &compact_priority,
                &compaction_retries))
        goto retry;
    //回收、压缩内存已经失败了,开始尝试杀死进程,回收内存页面
    page = __alloc_pages_may_oom(gfp_mask, order, ac, &did_some_progress);
    if (page)
        goto got_pg;
got_pg:
    return page;
}
内存压缩不是指压缩内存中的数据,而是指移动内存页面,进行内存碎片整理,腾出更大的连续的内存空间。如果内存碎片整理了,还是不能成功分配内存,就要杀死进程以便释放更多内存页面
如何分配内存页面?
实际完成分配任务的是 rmqueue 函数
static inline struct page *rmqueue(struct zone *preferred_zone,
            struct zone *zone, unsigned int order,
            gfp_t gfp_flags, unsigned int alloc_flags,
            int migratetype)
{
    unsigned long flags;
    struct page *page;
    if (likely(order == 0)) {
        if (!IS_ENABLED(CONFIG_CMA) || alloc_flags & ALLOC_CMA ||
                migratetype != MIGRATE_MOVABLE) {
    //如果order等于0,就说明是分配一个页面,说就从pcplist中分配
            page = rmqueue_pcplist(preferred_zone, zone, gfp_flags,
                    migratetype, alloc_flags);
            goto out;
        }
    }
    //加锁并关中断
    spin_lock_irqsave(&zone->lock, flags);
    do {
        page = NULL;
        if (order > 0 && alloc_flags & ALLOC_HARDER) {
        //从free_area中分配
            page = __rmqueue_smallest(zone, order, MIGRATE_HIGHATOMIC);
        }
        if (!page)
        //它最后也是调用__rmqueue_smallest函数
            page = __rmqueue(zone, order, migratetype, alloc_flags);
    } while (page && check_new_pages(page, order));
    spin_unlock(&zone->lock);
    zone_statistics(preferred_zone, zone);
    local_irq_restore(flags);
out:
    return page;
}
rmqueue_pcplist 函数,在请求分配一个页面的时候,就是用它从 pcplist 中分配页面的。所谓的 pcp 是指,每个 CPU 都有一个内存页面高速缓冲,由数据结构 per_cpu_pageset 描述,包含在内存区中。
在 Linux 内核中,系统会经常请求和释放单个页面。如果针对每个 CPU,都建立出预先分配了单个内存页面的链表,用于满足本地 CPU 发出的单一内存请求,就能提升系统的性能
struct per_cpu_pages {
    int count;      //列表中的页面数
    int high;       //页面数高于水位线,需要清空
    int batch;      //从伙伴系统增加/删除的块数
    //页面列表,每个迁移类型一个。
    struct list_head lists[MIGRATE_PCPTYPES];
};
struct per_cpu_pageset {
    struct per_cpu_pages pcp;
#ifdef CONFIG_NUMA
    s8 expire;
    u16 vm_numa_stat_diff[NR_VM_NUMA_STAT_ITEMS];
#endif
#ifdef CONFIG_SMP
    s8 stat_threshold;
    s8 vm_stat_diff[NR_VM_ZONE_STAT_ITEMS];
#endif
};
static struct page *__rmqueue_pcplist(struct zone *zone, int migratetype,unsigned int alloc_flags,struct per_cpu_pages *pcp,
            struct list_head *list)
{
    struct page *page;
    do {
        if (list_empty(list)) {
            //如果list为空,就从这个内存区中分配一部分页面到pcp中来
            pcp->count += rmqueue_bulk(zone, 0,
                    pcp->batch, list,
                    migratetype, alloc_flags);
            if (unlikely(list_empty(list)))
                return NULL;
        }
        //获取list上第一个page结构
        page = list_first_entry(list, struct page, lru);
        //脱链
        list_del(&page->lru);
        //减少pcp页面计数
        pcp->count--;
    } while (check_new_pcp(page));
    return page;
}
static struct page *rmqueue_pcplist(struct zone *preferred_zone,
            struct zone *zone, gfp_t gfp_flags,int migratetype, unsigned int alloc_flags)
{
    struct per_cpu_pages *pcp;
    struct list_head *list;
    struct page *page;
    unsigned long flags;
    //关中断
    local_irq_save(flags);
    //获取当前CPU下的pcp
    pcp = &this_cpu_ptr(zone->pageset)->pcp;
    //获取pcp下迁移的list链表
    list = &pcp->lists[migratetype];
    //摘取list上的page结构
    page = __rmqueue_pcplist(zone,  migratetype, alloc_flags, pcp, list);
    //开中断
    local_irq_restore(flags);
    return page;
}
但是,遇到多个内存页面的分配请求,就会调用 __rmqueue_smallest 函数,从 free_area 数组中分配。
static inline struct page *get_page_from_free_area(struct free_area *area,int migratetype)
{//返回free_list[migratetype]中的第一个page若没有就返回NULL
    return list_first_entry_or_null(&area->free_list[migratetype],
                    struct page, lru);
}
static inline void del_page_from_free_list(struct page *page, struct zone *zone,unsigned int order)
{
    if (page_reported(page))
        __ClearPageReported(page);
    //脱链
    list_del(&page->lru);
    //清除page中伙伴系统的标志
    __ClearPageBuddy(page);
    set_page_private(page, 0);
    //减少free_area中页面计数
    zone->free_area[order].nr_free--;
}

static inline void add_to_free_list(struct page *page, struct zone *zone,
                    unsigned int order, int migratetype)
{
    struct free_area *area = &zone->free_area[order];
    //把一组page的首个page加入对应的free_area中
    list_add(&page->lru, &area->free_list[migratetype]);
    area->nr_free++;
}
//分割一组页
static inline void expand(struct zone *zone, struct page *page,
    int low, int high, int migratetype)
{
    //最高order下连续的page数 比如high = 3 size=8
    unsigned long size = 1 << high;
    while (high > low) {
        high--;
        size >>= 1;//每次循环左移一位 4,2,1
        //标记为保护页,当其伙伴被释放时,允许合并
        if (set_page_guard(zone, &page[size], high, migratetype))
            continue;
        //把另一半pages加入对应的free_area中
        add_to_free_list(&page[size], zone, high, migratetype);
        //设置伙伴
        set_buddy_order(&page[size], high);
    }
}

static __always_inline struct page *__rmqueue_smallest(struct zone *zone, unsigned int order,int migratetype)
{
    unsigned int current_order;
    struct free_area *area;
    struct page *page;
    for (current_order = order; current_order < MAX_ORDER; ++current_order) {
        //获取current_order对应的free_area
        area = &(zone->free_area[current_order]);
        //获取free_area中对应migratetype为下标的free_list中的page
        page = get_page_from_free_area(area, migratetype);
        if (!page)
            continue;
        //脱链page
        del_page_from_free_list(page, zone, current_order);
        //分割伙伴
        expand(zone, page, order, current_order, migratetype);
        set_pcppage_migratetype(page, migratetype);
        return page;
    }
    return NULL;
}
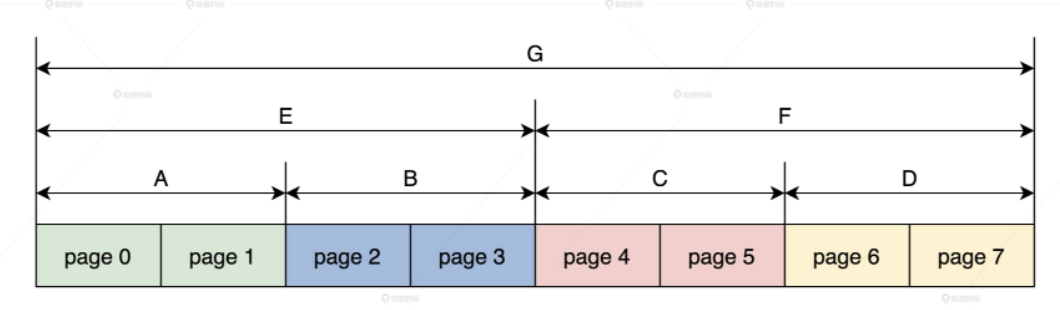
分割伙伴页面,然后加入到新的伙伴上。

则移山填海之难,
终有成功之日!
——孙文
 评论
