从零到一手写操作系统(五、同步 2)linux的实现)
如果追忆会荡起涟漪,那么今天的秋红落叶和晴空万里都归你
https://aeneag.xyz
微信公众号:技术乱舞
艾恩凝
手写操作系统目录
同步
5.5)linux自旋锁与信号量的实现
5.5.1)原子
https://pic.aeneag.xyz/linux_kernel.pdf 46页
5.5.2)中断
linux中断代码,与前文讲的原理基本相同,就是进行了封装
//实际保存eflags寄存器
extern __always_inline unsigned long native_save_fl(void){
    unsigned long flags;
    asm volatile("# __raw_save_flags\n\t"
                 "pushf ; pop %0":"=rm"(flags)::"memory");
    return flags;
}
//实际恢复eflags寄存器
extern inline void native_restore_fl(unsigned long flags){
    asm volatile("push %0 ; popf"::"g"(flags):"memory","cc");
}
//实际关中断
static __always_inline void native_irq_disable(void){
    asm volatile("cli":::"memory");
}
//实际开启中断
static __always_inline void native_irq_enable(void){
    asm volatile("sti":::"memory");
}
//arch层关中断
static __always_inline void arch_local_irq_disable(void){
    native_irq_disable();
}
//arch层开启中断
static __always_inline void arch_local_irq_enable(void){
    native_irq_enable();
}
//arch层保存eflags寄存器
static __always_inline unsigned long           arch_local_save_flags(void){
    return native_save_fl();
}
//arch层恢复eflags寄存器
static  __always_inline void arch_local_irq_restore(unsigned long flags){
    native_restore_fl(flags);
}
//实际保存eflags寄存器并关中断
static __always_inline unsigned long arch_local_irq_save(void){
    unsigned long flags = arch_local_save_flags();
    arch_local_irq_disable();
    return flags;
}
//raw层关闭开启中断宏
#define raw_local_irq_disable()     arch_local_irq_disable()
#define raw_local_irq_enable()      arch_local_irq_enable()
//raw层保存恢复eflags寄存器宏
#define raw_local_irq_save(flags)           \
    do {                        \
        typecheck(unsigned long, flags);    \
        flags = arch_local_irq_save();      \
    } while (0)

#define raw_local_irq_restore(flags)            \
    do {                        \
        typecheck(unsigned long, flags);    \
        arch_local_irq_restore(flags);      \
    } while (0)

#define raw_local_save_flags(flags)         \
    do {                        \
        typecheck(unsigned long, flags);    \
        flags = arch_local_save_flags();    \
    } while (0)
//通用层接口宏
#define local_irq_enable()              \
    do { \
        raw_local_irq_enable();         \
    } while (0)

#define local_irq_disable()             \
    do {                        \
        raw_local_irq_disable();        \
    } while (0)

#define local_irq_save(flags)               \
    do {                        \
        raw_local_irq_save(flags);      \
    } while (0)

#define local_irq_restore(flags)            \
    do {                        \
        raw_local_irq_restore(flags);       \
    } while (0)
5.5.3)自旋锁
linux实现原始自旋锁与前文大同小异
5.5.3.1)排队自旋锁
为什么要排队?搞清这个问题就明白了这个的由来
首先当多个进程获取同一个资源时,有一个获取了,后面的那些在等待,有先来的有后来的,一旦该资源释放了,那么下一个应该是谁获取这个资源呢?这并不确定,有时会造成早来等待的却最后获取资源,这就造成了不公平,排队自旋锁就是解决这个问题了。
static inline void __raw_spin_lock(raw_spinlock_t*lock){
int inc = 0x00010000;
int tmp;
__asm__ __volatile__(
"lock ; xaddl %0, %1\n" //将inc和slock交换,然后 inc=inc+slock
                        //相当于原子读取next和owner并对next+1
"movzwl %w0, %2\n\t"//将inc的低16位做0扩展后送tmp tmp=(u16)inc
"shrl $16, %0\n\t" //将inc右移16位 inc=inc>>16
"1:\t"
"cmpl %0, %2\n\t" //比较inc和tmp,即比较next和owner
"je 2f\n\t" //相等则跳转到标号2处返回
"rep ; nop\n\t" //空指令
"movzwl %1, %2\n\t" //将slock的低16位做0扩展后送tmp 即tmp=owner
"jmp 1b\n" //跳转到标号1处继续比较
"2:"
:"+Q"(inc),"+m"(lock->slock),"=r"(tmp)
::"memory","cc"
);
}
#define UNLOCK_LOCK_PREFIX LOCK_PREFIX
static inline void __raw_spin_unlock(raw_spinlock_t*lock){
__asm__ __volatile__(
UNLOCK_LOCK_PREFIX"incw %0"//将slock的低16位加1 即owner+1
:"+m"(lock->slock)
::"memory","cc");
}
要明白排队自旋锁的原理,一个owner+next 就是 lock 高16低16位,初始化为0,获取锁 next +1 ;并判断当前owner和next 是否相等,相等就获取资源,释放后,owner+1.那么下一个资源的next = 1,实际的next又+1,这时第二个owner = 1 保存的next =1 第二个进程获取资源,就是这样排队下去获取同一个资源。
5.5.3.2)尝试获取锁
当一个进程发现另一个进程已经拥有自己所请求的自旋锁时,就自愿放弃,转而做其它别的工作,并不想在这里循环等待,浪费自己的时间。这就是尝试获取锁。
static inline int __raw_spin_trylock(raw_spinlock_t*lock){
    int tmp;
    int new;
    asm volatile(
    "movl %2,%0\n\t"//tmp=slock
    "movl %0,%1\n\t"//new=tmp
    "roll $16, %0\n\t"//tmp循环左移16位,即next和owner交换了
    "cmpl %0,%1\n\t"//比较tmp和new即(owner、next)?=(next、owner)
    "jne 1f\n\t" //不等则跳转到标号1处
    "addl $0x00010000, %1\n\t"//相当于next+1
    "lock ; cmpxchgl %1,%2\n\t"//new和slock交换比较
    "1:"
    "sete %b1\n\t" //new = eflags.ZF位,ZF取决于前面的判断是否相等
    "movzbl %b1,%0\n\t" //tmp = new
    :"=&a"(tmp),"=Q"(new),"+m"(lock->slock)
    ::"memory","cc");
    return tmp;
}
int __lockfunc _spin_trylock(spinlock_t*lock){
    preempt_disable();
    if(_raw_spin_trylock(lock)){
        spin_acquire(&lock->dep_map,0,1,_RET_IP_);
        return 1;
    }
    preempt_enable();
    return 0;
}
#define spin_trylock(lock) __cond_lock(lock, _spin_trylock(lock))
_spin_trylock 返回 1 表示尝试加锁成功,可以安全的地问共享资源了;返回值为 0 则表示尝试加锁失败,不能操作共享资源,应该等一段时间,再次尝试加锁。
5.5.4)信号量
信号量最大的优势是既可以使申请失败的进程睡眠,还可以作为资源计数器使用。
信号量数据结构:
struct semaphore{
    raw_spinlock_t lock;//保护信号量自身的自旋锁
    unsigned int count;//信号量值
    struct list_head wait_list;//挂载睡眠等待进程的链表
};
具体实现代码:
static inline int __sched __down_common(struct semaphore *sem, long state,long timeout)
{
    struct semaphore_waiter waiter;
    //把waiter加入sem->wait_list的头部
    list_add_tail(&waiter.list, &sem->wait_list);
    waiter.task = current;//current表示当前进程,即调用该函数的进程
    waiter.up = false;
    for (;;) {
        if (signal_pending_state(state, current))
            goto interrupted;
        if (unlikely(timeout <= 0))
            goto timed_out;
        __set_current_state(state);//设置当前进程的状态,进程睡眠,即先前__down函数中传入的TASK_UNINTERRUPTIBLE:该状态是等待资源有效时唤醒(比如等待键盘输入、socket连接、信号(signal)等等),但不可以被中断唤醒
        raw_spin_unlock_irq(&sem->lock);//释放在down函数中加的锁
        timeout = schedule_timeout(timeout);//真正进入睡眠
        raw_spin_lock_irq(&sem->lock);//进程下次运行会回到这里,所以要加锁
        if (waiter.up)
            return 0;
    }
 timed_out:
    list_del(&waiter.list);
    return -ETIME;
 interrupted:
    list_del(&waiter.list);
    return -EINTR;

    //为了简单起见处理进程信号(signal)和超时的逻辑代码我已经删除
}
//进入睡眠等待
static noinline void __sched __down(struct semaphore *sem)
{
    __down_common(sem, TASK_UNINTERRUPTIBLE, MAX_SCHEDULE_TIMEOUT);
}
//获取信号量
void down(struct semaphore *sem)
{
    unsigned long flags;
    //对信号量本身加锁并关中断,也许另一段代码也在操作该信号量
    raw_spin_lock_irqsave(&sem->lock, flags);
    if (likely(sem->count > 0))
        sem->count--;//如果信号量值大于0,则对其减1
    else
        __down(sem);//否则让当前进程进入睡眠
    raw_spin_unlock_irqrestore(&sem->lock, flags);
}
//实际唤醒进程
static noinline void __sched __up(struct semaphore *sem)
{
    struct semaphore_waiter *waiter = list_first_entry(&sem->wait_list, struct semaphore_waiter, list);
    //获取信号量等待链表中的第一个数据结构semaphore_waiter,它里面保存着睡眠进程的指针
    list_del(&waiter->list);
    waiter->up = true;
    wake_up_process(waiter->task);//唤醒进程重新加入调度队列
}
//释放信号量
void up(struct semaphore *sem)
{
    unsigned long flags;
    //对信号量本身加锁并关中断,必须另一段代码也在操作该信号量
    raw_spin_lock_irqsave(&sem->lock, flags);
    if (likely(list_empty(&sem->wait_list)))
        sem->count++;//如果信号量等待链表中为空,则对信号量值加1
    else
        __up(sem);//否则执行唤醒进程相关的操作
    raw_spin_unlock_irqrestore(&sem->lock, flags);
}
5.5.5)读写锁
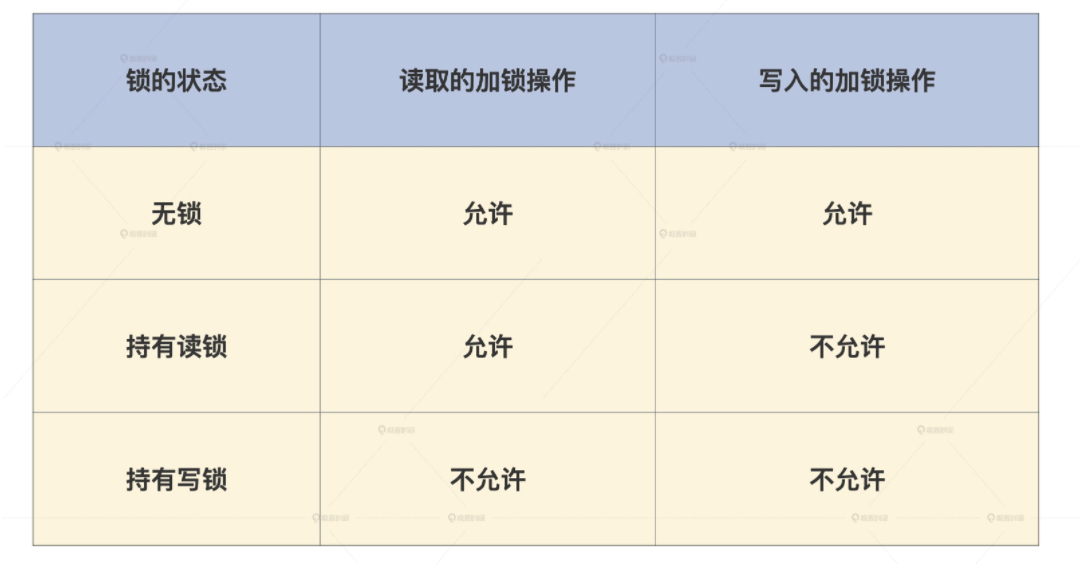
- 获取读锁时,锁值变量 lock 计数减去 1,判断结果的符号位是否为 1。若结果符号位为 0 时,获取读锁成功,即表示 lock 大于 0。
- 获取读锁时,锁值变量 lock 计数减去 1,判断结果的符号位是否为 1。若结果符号位为 1 时,获取读锁失败,表示此时读写锁被修改数据的进程占有,此时调用 read_lock_failed 失败处理函数,循环测试 lock+1 的值,直到结果的值大于等于 1。
- 获取写锁时,锁值变量 lock 计数减去 RW_LOCK_BIAS_STR,即 lock-0x01000000,判断结果是否为 0。若结果为 0 时,表示获取写锁成功。
- 获取写锁时,锁值变量 lock 计数减去 RW_LOCK_BIAS_STR,即 lock-0x01000000,判断结果是否为 0。若结果不为 0 时,获取写锁失败,表示此时有读取数据的进程占有读锁或有修改数据的进程占有写锁,此时调用 write_lock_failed 失败处理函数,循环测试 lock+0x01000000,直到结果的值等于 0x01000000。
//读写锁初始化锁值
#define RW_LOCK_BIAS     0x01000000
//读写锁的底层数据结构
typedef struct{
    unsigned int lock;
}arch_rwlock_t;
//释放读锁
static inline void arch_read_unlock(arch_rwlock_t*rw){
    asm volatile(
        LOCK_PREFIX"incl %0" //原子对lock加1
        :"+m"(rw->lock)::"memory");
}
//释放写锁
static inline void arch_write_unlock(arch_rwlock_t*rw){
    asm volatile(
        LOCK_PREFIX"addl %1, %0"//原子对lock加上RW_LOCK_BIAS
        :"+m"(rw->lock):"i"(RW_LOCK_BIAS):"memory");
}
//获取写锁失败时调用
ENTRY(__write_lock_failed)
    //(%eax)表示由eax指向的内存空间是调用者传进来的
    2:LOCK_PREFIX addl  $ RW_LOCK_BIAS,(%eax)
    1:rep;nop//空指令
    cmpl $RW_LOCK_BIAS,(%eax)
    //不等于初始值则循环比较,相等则表示有进程释放了写锁
    jne   1b
    //执行加写锁
    LOCK_PREFIX subl  $ RW_LOCK_BIAS,(%eax)
    jnz 2b //不为0则继续测试,为0则表示加写锁成功
    ret //返回
ENDPROC(__write_lock_failed)
//获取读锁失败时调用
ENTRY(__read_lock_failed)
    //(%eax)表示由eax指向的内存空间是调用者传进来的
    2:LOCK_PREFIX incl(%eax)//原子加1
    1:  rep; nop//空指令
    cmpl  $1,(%eax) //和1比较 小于0则
    js 1b //为负则继续循环比较
    LOCK_PREFIX decl(%eax) //加读锁
    js  2b  //为负则继续加1并比较,否则返回
    ret //返回
ENDPROC(__read_lock_failed)
//获取读锁
static inline void arch_read_lock(arch_rwlock_t*rw){
    asm volatile(
        LOCK_PREFIX" subl $1,(%0)\n\t"//原子对lock减1
        "jns 1f\n"//不为小于0则跳转标号1处,表示获取读锁成功
        "call __read_lock_failed\n\t"//调用__read_lock_failed
        "1:\n"
        ::LOCK_PTR_REG(rw):"memory");
}
//获取写锁
static inline void arch_write_lock(arch_rwlock_t*rw){
    asm volatile(
        LOCK_PREFIX"subl %1,(%0)\n\t"//原子对lock减去RW_LOCK_BIAS
        "jz 1f\n"//为0则跳转标号1处
        "call __write_lock_failed\n\t"//调用__write_lock_failed
        "1:\n"
        ::LOCK_PTR_REG(rw),"i"(RW_LOCK_BIAS):"memory");
}
手写操作系统目录

吾心信其可行,
则移山填海之难,
终有成功之日!
——孙文
则移山填海之难,
终有成功之日!
——孙文
 评论
0 评论
